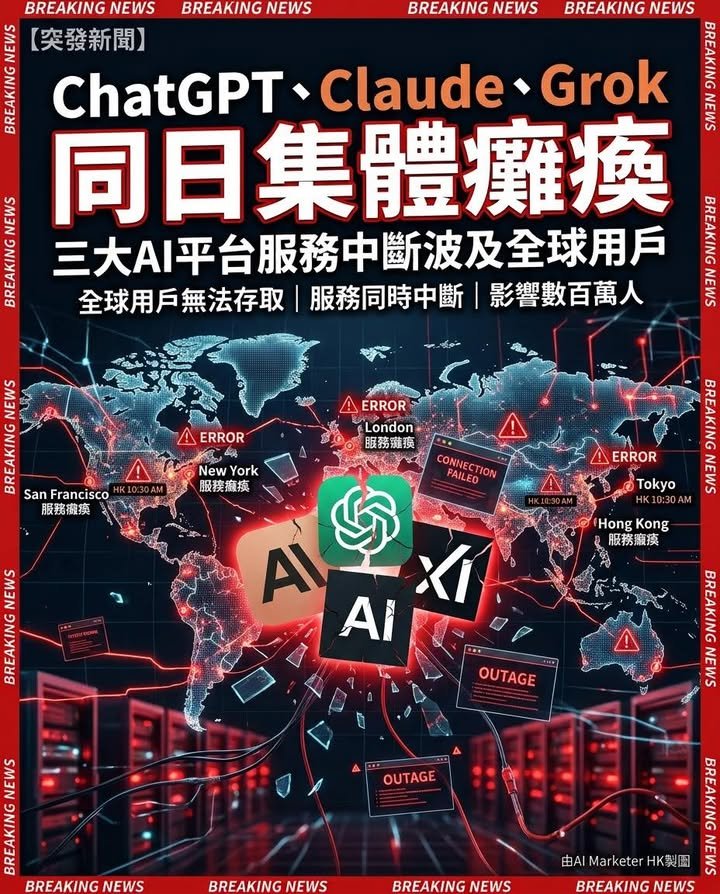
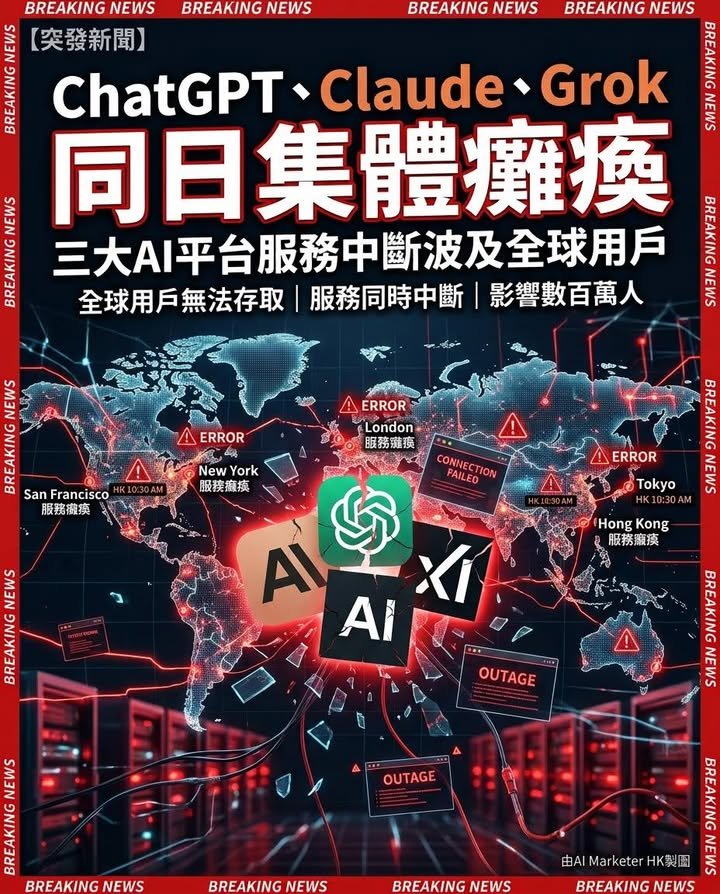
ChatGPT、Claude與Grok同日集體癱瘓!
三大AI平台服務中斷波及全球用戶 罕見同步當機惹雲端基建憂慮
美國三大人工智能平台——OpenAI旗下ChatGPT、Anthropic旗下Claude,以及馬斯克創辦的xAI旗下Grok,於9月3日晚(香港時間)先後出現服務中斷,三個平台同步故障情況罕見,一度令全球大量用戶無法正常使用相關服務,事件亦引發市場對雲端運算基礎設施穩定性的關注。
📢 故障時間線
是次事故分兩輪發生。第一輪較早出現,Anthropic的Claude Sonnet 5模型於當晚20時37分(香港時間,下同)錄得錯誤率上升,公司工程團隊隨即展開調查,事故僅維持約19分鐘,至20時56分已宣布恢復正常。
約半小時後,第二輪範圍更廣的故障接踵而至。21時26分,Claude再度出現問題,今次影響擴展至Mythos/Fable 5.1、Mythos/Fable 5,以及Opus 5、4.8及4.6等多個模型,claude.ai網站、應用程式介面、Claude Code及Claude Cowork均一度受到牽連。幾乎同一時間,xAI旗下Grok亦傳出存取異常,21時30分officially被標示為服務中斷,美國東、西部部分地區的應用程式介面成功率一度跌至約79%至82%,用戶普遍見到系統提示指服務暫時無法使用。
至22時43分,ChatGPT及程式開發工具Codex亦加入故障名單,OpenAI狀態頁顯示事故涉及登入、檔案上載、語音模式、搜尋、深度研究及圖像生成等15項ChatGPT功能,以及4項Codex功能。公司工程團隊其後於23時17分實施緩解措施,23時50分將事故狀態轉為監察,服務逐步回穩,並於翌日(9月4日)零時55分正式宣布事故完全解決。網路監測平台Downdetector顯示,關於OpenAI服務異常的用戶報告一度超過1.2萬宗,個別統計高峰時更錄得近4萬宗。
Anthropic方面,公司大部分受影響模型於凌晨零時15分左右已恢復至正常錯誤率水平,惟Opus 4.8及Opus 5兩個模型持續出現問題,恢復時間相對較長。
📝 故障成因未有定論
多間傳媒報道指出,事件發生期間,微軟雲端服務Azure的故障報告亦同步顯著增加,成為外界關注的潛在原因之一。由於ChatGPT、Claude及Grok的運算基礎設施均部分依賴Azure,理論上若Azure個別地區或核心服務出現異常,有可能對倚賴其算力、網絡或儲存能力的AI平台造成連鎖影響。
不過,截至報道時,涉事三間公司均未正式確認事故根本成因,Azure是否為共同肇因仍屬外界推測,並無官方證實。Anthropic一名技術人員在社交平台X表示,故障源於「基礎設施問題」,惟未有透露具體技術細節;OpenAI則指事故與系統路由錯誤有關。三間公司均未提及事件與網絡攻擊有關。
值得留意的是,Google旗下Gemini同期亦有用戶回報存取問題,惟其服務運行於Google Cloud而非Azure,恢復時間反而是三大供應商中最長,需時約兩小時,顯示是次事件未必單純與單一雲端服務供應商有關。
🤖 波及第三方開發工具
由於愈來愈多企業及開發者工具依賴大型語言模型作為底層技術,是次故障亦影響第三方應用程式。其中,人工智能程式開發工具Cursor因部分程式碼生成及輔助開發功能依賴Claude、ChatGPT及Grok提供支援,其服務亦一併受到牽連。
事件反映生成式人工智能已深度融入企業工作流程及軟件開發環節,一旦多家主要模型供應商同步發生故障,影響範圍已不再局限於個別聊天機械人,而可能傳導至下游的開發工具及企業應用系統。有分析認為,企業用戶日後或需採用多模型串接、服務降級機制,以及配置備用雲端資源,藉此降低單一供應商大規模服務中斷所帶來的風險。
撰文:AI Marketer HK 編輯室
————
👇 相信「AI × 數碼營銷」是未來的你,
歡迎 Tag 一位同行好友,一起成長!
#AIMarketerHK #DigitalMarketing #chatgpt #grok #claude