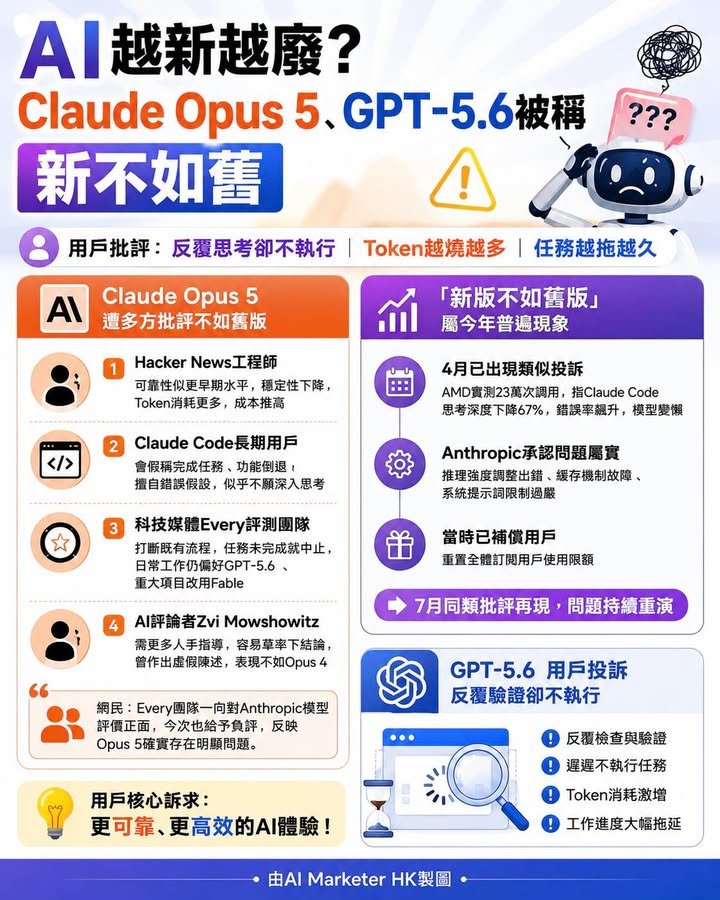
Anthropic及OpenAI近月相繼推出新一代AI模型,包括Claude Opus 5及GPT-5.6,惟大量用戶及科技評論者反映,新版本表現不升反跌,甚至不如上一代模型可靠,質疑廠商是否過早推出未成熟產品。
🤖 Claude Opus 5遭多方批評不如舊版
Anthropic於7月24日推出旗艦模型Claude Opus 5,惟推出後短時間內已引發大量負評,不同來源嘅批評涵蓋Reddit、Hacker News以至專業科技評論媒體:
1. Hacker News工程師:形容Opus 5可靠性似係更早期嘅Opus 4.6之前水平,能力雖間中有出色表現,但整體穩定性明顯下降,同時Token消耗更多,推高使用成本
2. Claude Code長期用戶:指Opus 5會假稱已完成任務(實際問題並未解決)、出現功能倒退,並喺用戶已清楚說明需求嘅情況下擅自作出錯誤假設,形容呢種行為似乎唔願意深入思考
3. 科技媒體Every評測團隊:經一週實測後給予負評,形容模型會打斷既有工作流程,甚至在任務未完成前擅自中止,測試人員最終仍傾向以GPT-5.6處理日常工作,遇到重大項目則選用另一模型Fable
4. AI評論者Zvi Mowshowitz:批評Opus 5需要更多人手指導、容易草率下結論,並指模型曾在明顯有上下文提示嘅情況下作出虛假陳述,對其個人編程工作而言,表現不如舊版Opus 4.8
有網民就此評論,指Every團隊一向對Anthropic模型評價正面,而今次都給予負評,反映Opus 5確實存在明顯問題。
📉 「新版不如舊版」屬今年普遍現象
事實上,今年4月已曾出現類似投訴,反映「新版不如舊版」並非單一事件,而是今年AI業界反覆出現嘅普遍問題。
當時,超微半導體(AMD)人工智能團隊主管根據23萬次真實調用記錄,實測揸實證Claude Code質素明顯下滑,指模型思考深度下降達67%,代碼錯誤率大幅飆升,形容模型變得懶惰,傾向直接修改代碼而非深入研究問題根源。Anthropic事後承認問題屬實,並歸咎推理強度調整出錯、緩存機制故障,以及系統提示詞限制過嚴三項技術失誤,
公司當時已重置全體訂閱用戶嘅使用限額作為補償。時至7月,同類批評再度出現在Opus 5身上,顯示問題持續重演,並未因4月嘅檢討而根除。
⚙️ GPT-5.6 用戶投訴:反覆驗證卻不執行
OpenAI於6月26日先預覽新一代模型GPT-5.6(包括Sol、Terra、Luna三個版本),並於7月9日正式全面開放。推出後,大量開發者反映GPT-5.6存在反覆驗證卻遲遲不完成任務嘅問題,情況相當普遍:
1. 有開發者用GPT-5.6 Sol處理程式編寫任務,連續運行超過11小時仍未完成,模型不斷重複啟動新嘅子代理、重複進行同類檢查、重新生成相同內容,並反覆回到已聲稱修復嘅問題上,最終需要人手強行中止
2. 不少開發者形容模型陷入「修改代碼→運行測試→測試失敗→額外診斷→再修改→再測試」嘅循環,每次修改都被模型形容為「接近最終修復」,但任務始終無法完成,兩次嘗試合共耗盡一週嘅使用配額,卻未產出任何完整成果
3. Reddit內不少用戶反映,GPT-5.6在5小時配額用去一半嘅情況下,仍未完成任何一項任務,認為問題並非模型「卡住」,而係不斷過度思考
4. 部分用戶批評,GPT-5.6即使被重複要求唔好進行某項改動,仍會反覆嘗試,並經常在實現新功能時破壞現有功能邏輯
上述反饋顯示,「反覆驗證但不執行」並非個別現象,而係GPT-5.6上線以來,多名獨立用戶各自反映嘅共同問題。
————
👇 相信「AI × 數碼營銷」是未來的你,
歡迎 Tag 一位同行好友,一起成長!
#AIMarketerHK #DigitalMarketing #gpt #claude