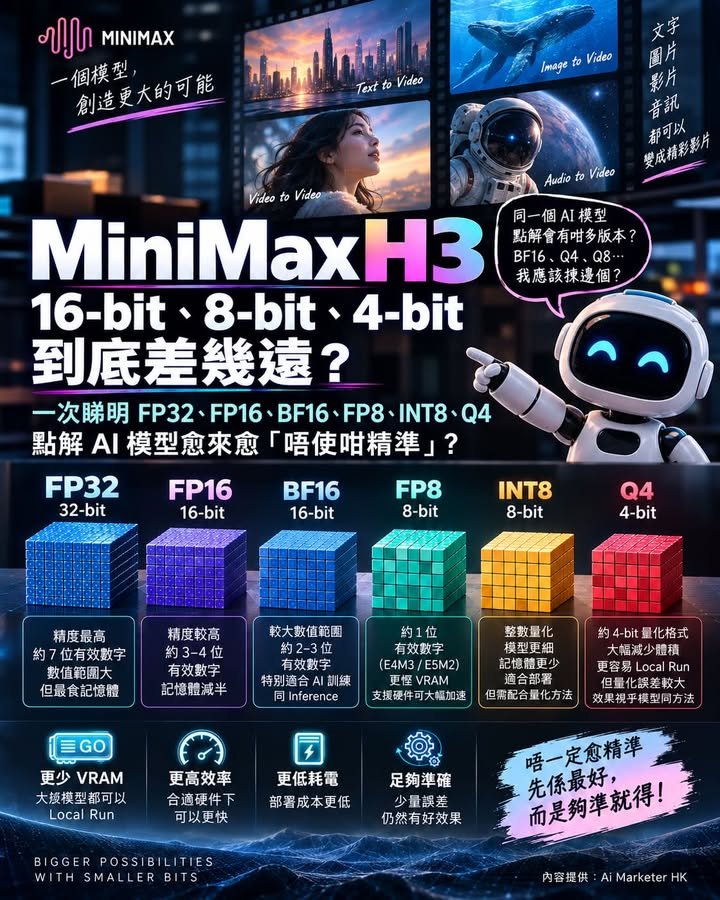
【MiniMax H3:16-bit、8-bit、4-bit 到底差幾遠?一次睇明 BF16、FP8、INT8、Q4,點解 AI 模型愈來愈「唔使咁精準」?】
最近下載開源 AI 模型,你可能成日見到:
FP32
FP16
BF16
FP8
INT8
Q4
對一般用家嚟講,呢堆英文字母同數字真係幾容易令人頭痛。
其實佢哋都同一個核心問題有關:
電腦究竟用幾多 bit、幾高嘅數值精度,去保存同運算 AI 模型入面嘅數字?
不過首先要講清楚:
FP32、FP16、BF16、FP8 主要係不同嘅 floating-point 浮點格式;
INT8 就係用 8-bit integer 做量化;
而 Q4 通常泛指大約 4-bit 嘅量化格式。
所以佢哋全部都同「降低數值表示精度」有關,但技術原理並唔完全一樣。
簡單理解:
FP32:精度高,但記憶體需求亦高
FP16 / BF16:今日 AI 非常常見嘅 16-bit 格式
FP8:進一步降低浮點精度
INT8:將數值量化成 8-bit integer
Q4:將模型權重進一步壓到約 4-bit
而有一樣嘢好多人容易誤會:
Precision 唔係代表「小數點後保留幾多位」。
真正講緊嘅係有效數字,以及可以表示嘅數值範圍。
如果只係用十進制做一個方便理解嘅近似:
FP32:約 7 位有效十進制數字
FP16:約 3–4 位有效數字
BF16:約 2–3 位有效數字
FP8:約 1 位左右有效數字,視乎 E4M3 / E5M2 格式
例如有一個數字:
1.23456789
如果純粹用十進制直覺化去想,可以想像成:
FP32:大約仲見到 1.234568
FP16:大約去到 1.235
BF16:大約去到 1.23
FP8:可能只剩下 1.2 呢個級別嘅精細度
要留意,呢個只係幫大家理解「有效數字減少」嘅示意,唔係實際 IEEE floating-point rounding 結果。
真正電腦入面係用二進制表示,所以實際數值會有所不同。
但概念就係:
Precision 愈低,可以準確分辨嘅數值細節就愈少。
聽落好似好危險。
但 AI 最有趣嘅地方就係:
好多神經網絡其實唔需要每一個 weight、activation 都精準到咁多位。
只要誤差控制得好,最後生成出嚟嘅文字、圖片、影片或者聲音,效果仍然可能同高精度版本非常接近。
呢個亦係 Quantization——量化——近年咁重要嘅原因。
以最近開源嘅 影音生成模型 MiniMax H3 為例。
MiniMax 官方提供嘅 H3-Base checkpoint 主要使用 BF16。
但模型開源之後,社群好快就出現 Q8、Q4 等量化版本,亦有人使用 FP8 等方式降低部署要求。
目的好簡單:
將原本需要大量 GPU 記憶體嘅模型,壓縮到更多硬件都可以運行。
例如其中一套 MiniMax H3 社群 GGUF 版本:
Q8 大約 20–21GB
Q4 大約 11.4GB
由呢個例子已經可以睇到量化對模型體積嘅影響。
如果純粹由理論上計模型 weights:
16-bit:每個參數約 2 bytes
8-bit:約 1 byte
4-bit:約 0.5 byte
所以同一批權重,由 16-bit 變成 8-bit,理論儲存量可以減少約一半;
由 16-bit 去到 4-bit,就可以去到大約四分之一。
但有一個好重要嘅「但是」。
模型檔案細咗四分三,唔代表實際運行 VRAM 一定亦少四分三。
因為 AI inference 仲有:
activations
KV cache
context
VAE
text encoder
temporary buffers
等等其他記憶體開支。
所以「16 → 8 → 4 bit」主要係講數值表示同模型權重所需空間,而唔係整部 AI 系統嘅 VRAM 一定按照同一比例下降。
再睇返幾種常見格式。
FP32
精度高,大約有 7 位有效十進制數字。
優點係數值誤差細、dynamic range 大、穩定性高。
缺點就係每個數字要用 32 bit,對大型 AI 模型嚟講,非常食記憶體同 bandwidth。
所以今日大型 AI inference 已經好少要求所有運算全部使用 FP32。
FP16
FP16 將每個數字縮到 16 bit。
相比 FP32,可以大幅降低記憶體同 bandwidth。
不過 FP16 嘅 exponent 比較少,所以可以表示嘅數值範圍亦比 FP32 窄。
BF16
BF16 都係 16 bit,但設計取向同 FP16 有啲唔同。
佢犧牲咗一部分有效數字精度,換取同 FP32 接近嘅 exponent range。
所以:
BF16 精細程度其實低過 FP16,但可以處理嘅數值範圍就大好多。
呢個亦係點解 BF16 喺 AI training 同 inference 入面非常流行。
FP8
去到 FP8,就只剩低好多嘅 precision。
常見有:
E4M3
E5M2
E4M3 畀多啲 bits mantissa,所以 precision 高啲;
E5M2 就畀多啲 bits exponent,所以 dynamic range 大啲,但 precision 更低。
FP8 嘅吸引力就係可以進一步降低 memory bandwidth,同支援 FP8 嘅 AI accelerator 配合時,有機會提高 throughput 同整體效率。
但佢並唔代表所有計算都可以隨便用 FP8。
實際 AI 系統好多時會採用 mixed precision:
部分運算用 FP8;
部分保留 BF16 / FP16;
某啲 accumulation 或敏感運算甚至保留更高精度。
INT8
INT8 又係另一種思路。
佢唔再用 floating point 去直接表示原本嘅數值,而係透過 scale 等方法,將一段 floating-point 數值映射成 8-bit integer。
最大好處係:
模型可以細好多;
記憶體 bandwidth 可以降低;
而喺支援 INT8 acceleration 嘅硬件上,亦有機會得到更高 throughput。
但量化方法做得唔好,就可能令模型 accuracy 或生成質素下降。
Q4
去到 Q4,就更加進取。
大致可以理解為將模型權重壓到約 4-bit。
好處非常直接:
模型檔案細好多;
VRAM / RAM 要求降低;
大型模型更加容易 Local Run。
代價就係量化誤差進一步增加。
部分模型可能幾乎睇唔出分別;
另一啲模型就可能出現:
細節下降
prompt adherence 下降
穩定性下降
特殊任務能力下降
所以 4-bit 並唔係永遠最好,亦唔係永遠最差。
仲要睇:
模型本身
量化演算法
哪些 layers 被量化
硬件
inference engine
kernel optimization
甚至你做緊咩任務。
同樣道理:
Bit 數低,亦唔代表一定跑得快。
低 bit 通常可以減少模型大小同 memory bandwidth;
但實際速度仍然要睇 GPU 有冇對應硬件支援、software stack 同 kernel 有冇優化。
有時一個高度優化嘅 8-bit 模型,甚至可以比某啲 4-bit implementation 跑得更快。
所以今日 AI 真正有趣嘅問題,已經唔再係:
「點樣將每一個數字計到最準?」
而係:
「最低可以用幾多 precision,而模型效果仍然保持喺可以接受嘅水平?」
呢個先係現代 AI Engineering 非常重要嘅 trade-off。
而亦因為咁,我哋唔應該話:
「今日嘅 GPU 已經放棄精準度。」
其實情況啱啱相反。
現代 GPU 提供嘅數值格式反而愈來愈多:
FP32
FP16
BF16
FP8
INT8
甚至更低 bit 嘅運算方式。
你真係需要高精度,硬件仍然可以做。
改變嘅係:
AI 模型同 AI 工程師開始學識,邊啲地方需要精準,邊啲地方其實「夠準就得」。
以前:
愈準愈好。
今日 AI:
用最低成本做到「足夠準」,可能先係最好。
因為你接受少量數值誤差,換返嚟嘅可能係:
更細模型
更少 VRAM
更低 memory bandwidth
更低耗電
更低部署成本
更高 throughput
甚至令一個原本你部電腦根本跑唔到嘅大型模型,而家可以 Local Run。
呢個亦係點解 Quantization,會成為 Local AI 時代一個愈來愈重要嘅技術。
所以,下次當你下載模型見到:
BF16、FP8、INT8、Q8、Q4……
你可以問嘅唔再只係:
「邊個版本最準?」
而係:
「我究竟需要幾準?」
呢個問題,可能更加重要。
內容提供:Ai Marketer HK