唔識寫文、只識揀答案
TypeSafe新模型Jev主攻AI決策
號稱快近200倍 惟官方數據惹質疑
美國AI初創公司TypeSafe AI於9月15日結束近2年隱身狀態,發布首款「System One」模型Jev。與ChatGPT、Claude等主流LLM (大型語言模型) 不同,Jev完全唔負責寫文字,只負責喺已定義嘅選項入面揀答案、評分或答是非,聲稱可大幅加快及降低AI代理程式(AI Agent)執行判斷嘅速度與成本。惟第三方分析發現,官方宣傳嘅「快近200倍」數字,實際比較對象揀得相當取巧,準確度亦未算突出。
💡Jev係咩:唔寫文字、只做決策
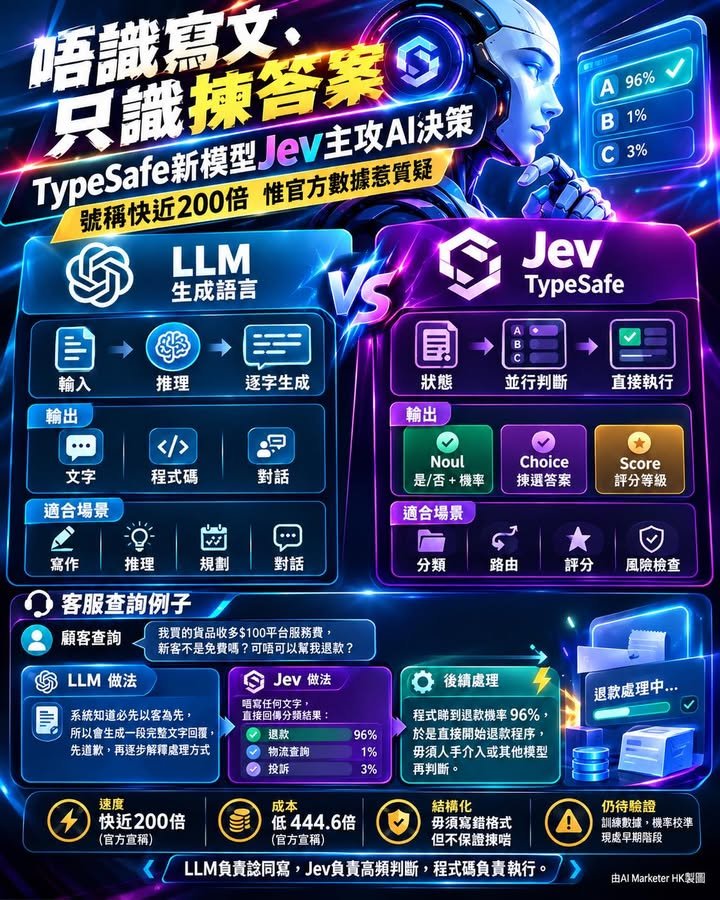
一般大型語言模型(LLM)例如ChatGPT、Claude,運作邏輯係「輸入、推理、生成文字」,即係接收指令之後,經過推理再逐字寫出一段回應。Jev嘅運作邏輯完全唔同,可以理解為「狀態、決策」,即係接收一堆非結構化資訊之後,唔會生成任何文字說明,而係直接回傳程式可以即時使用嘅typed result(類型化結果)。
TypeSafe將Jev嘅輸出方式歸納為3種「原語」(primitive):
– Noul:回答是或否,並附帶機率
– Choice:由一組候選答案中揀一個
– Score:按預設等級評分
3種原語均會同時提供機率分佈同信心指數,方便程式按數值高低分流,例如信心超過0.95自動執行,介乎0.7至0.95交返俾大型語言模型判斷,低於0.7先交人手處理。
👉🏻初步對照嚟講:
– 核心
LLM:生成語言
Jev:「if、then」式決策
– 輸出
LLM:文字、程式碼、對話
Jev:預設選項、機率、信心分數
📢 客服單一秒分流 毋須寫任何解釋
有咗以上概念,就可以睇一個具體例子點運作:
– 電商平台顧客查詢:「我買的貨品收多$100平台服務費,新客不是免費嗎?可唔可以幫我退款?」
– LLM做法:系統知道必先以客為先,所以會生成一段完整文字回覆,先道歉,再逐步解釋處理方式
– Jev做法:唔寫任何文字,直接回傳分類結果——退款96%、物流查詢1%、投訴3%
– 後續處理:程式睇到退款機率96%,於是直接開始退款程序,毋須人手介入或其他模型再判斷
✏️型別上唔可能寫錯格式 但唔保證揀啱
Jev最受關注嘅特點,係其答案空間喺輸入前已經預先鎖定,結構上唔可能吐出使用者未列明嘅選項,呢點同一般LLM靠「限制性解碼」硬套JSON格式、卻仍會間中格式跑掉甚至生成番一個根本唔存在嘅工具名稱,屬於完全唔同層次嘅保證,唔係機率低,而係型別上唔可能發生。
不過TypeSafe喺官方文件都明言,呢種保證只擔保答案一定喺清單之內,並唔擔保揀中嗰個係啱:「結構化唔等於正確」(Structured ≠ Correct)。
其實,Jev的判斷質素高度依賴輸入資料是否足夠。若問題所需嘅資訊已完整交代喺輸入文字入面,模型可以高信心迅速作出判斷;但一旦問題牽涉輸入文字冇提供嘅外部知識,模型即使得出錯誤判斷,仍可能維持相當高嘅信心水平,反映高信心並不等於答案正確。
📝官方數字與第三方查核
– 延遲:70至500毫秒
– 輸入收費:每100萬個代幣0.042美元(約0.33港元),輸出免費
– 官方宣稱優勢:速度快193.6倍、成本低444.6倍(比較對象為Claude Sonnet 5及Claude Opus 5)
– 第三方查核後:若改以GPT-5.6 Terra(官方認為智能水平最接近Jev嘅模型)作基準,速度優勢降至約25倍,成本優勢約76倍
至於準確度,官方喺安全事故處理、代理程式軌跡審查、發票處理及客戶服務分流4項內部評測中,Jev整體平均表現與GPT-5.6 Terra相若,惟細項參差:
– 發票處理:Jev 61.8%、GPT-5.6 Terra 74.7%、Claude Opus 5 78.4%
– 客戶服務分流:Jev表現最佳項目,準確度76%
– 評測方法限制:所謂「準確度」實際係指Jev答案與GPT-6 Astra及Claude Fable 5.1兩款頂尖模型平均判斷嘅一致程度,並非同人手標註嘅正確答案比對,故此結果只反映幾個模型判斷幾相似,未必等於邊個先係真正答啱
🧐 可達成零幻覺?
Jev 主打「零幻覺(Zero Hallucination)」,但必須釐清它消除的是「生成式文本幻覺」,而非「邏輯判斷錯誤」。
Jev 與傳統 LLM(如 GPT 或 Claude)最大分別在於輸出機制。傳統大模型採用逐字機率預測(Next-token prediction)來生成自由文本,當缺乏確定依據時,系統容易「一本正經地胡說八道」,憑空捏造事實、引文或給出錯誤格式。相反,Jev 屬於「型別安全(Type-Safe)決策模型」,它不負責寫長文或創作內容,底層嚴格限制它只能針對特定任務做確定性嘅結構化輸出——例如在預設嘅枚舉清單中做分類、計算匹配置信度(Score)或回傳布林值。既然它被剝奪了自由組織文字嘅權限,自然就從軟體工程機制上徹底排除了「格式失控」與「無中生有捏造內容」嘅文本幻覺。
然而,「沒有文本幻覺」並不等同於「答案永遠正確」。Jev 本質上依然是建基於機率計算嘅模型,佢嘅風險轉移到了「分類與決策誤判」上。舉例來說,當輸入一段語意模糊、帶有諷刺意味或涉及複雜中文語境嘅客戶反饋時,Jev 雖然絕對會規範地輸出一個預設選項,但它完全有可能把「投訴退款」錯誤歸類為「物流查詢」。換言之,Jev 解決了 AI 在自動化流程中「格式崩潰」和「胡言亂語」嘅痛點,但在核心業務判斷上,它依然存在誤判機率,實際應用時仍需配合信心閥值(Confidence Threshold)與人工複核機制。
🛡️未取代LLM 可能重塑AI代理程式分工
業界普遍認同,Jev嘅定位並非取代ChatGPT、Claude呢類生成式模型,而係專攻「判斷問題」,例如電郵應該分去邊一類、一筆交易可唔可疑、AI代理程式下一步應該揀邊一個工具、某個結果有冇違反政策。
有分析形容,呢種設計有機會令未來嘅AI應用出現更清晰分工:生成式模型負責諗同寫,「System One」類型嘅模型負責高頻判斷,傳統程式碼負責執行,令AI代理程式毋須每一步都要問一次GPT或Claude「而家應該做咩」,速度同成本都可以大幅改善。
不過亦有評論提醒,現時外界對Jev底層架構、訓練數據來源同機率校準方法所知甚少,官方所謂「機率經過校準」,即模型講信心0.8時實際準確率應該都係大約8成,暫時未有公開任何校準曲線或統計數據佐證。Jev目前仍處早期開放階段,須經輪候名單申請,透過應用程式介面存取,暫未提供開放權重或本地部署方案。
👉🏻整理:LLM與Jev完整比較
– 核心
LLM:生成語言
Jev:「if、then」式決策
– 流程
LLM:輸入、逐字生成、解析或驗證
Jev:狀態、並行判斷、直接執行
– 輸出
LLM:文字、程式碼、對話
Jev:預設選項、機率、信心分數
– 適合場景
LLM:寫作、推理、規劃、對話
Jev:分類、路由、評分、風險檢查
– 客戶查詢單例子
LLM:生成一段完整回覆解釋處理步驟;
Jev:直接回傳退款91%、轉交真人14%、客戶流失風險68%,交程式即時執行
兩者唔係取代關係,而係分工:LLM負責諗同寫,Jev負責高頻判斷,傳統程式碼負責實際執行。呢個新模型類別能否真正撼動現有AI代理程式嘅設計方式,仍有待更長時間同獨立第三方驗證。
✏️ 撰文:AI Marketer HK 編輯部
————
👇 相信「AI × 數碼營銷」是未來的你,
歡迎 Tag 一位同行好友,一起成長!
#AIMarketerHK #DigitalMarketing #jev #llm