Claude Opus 5.5 突然登場
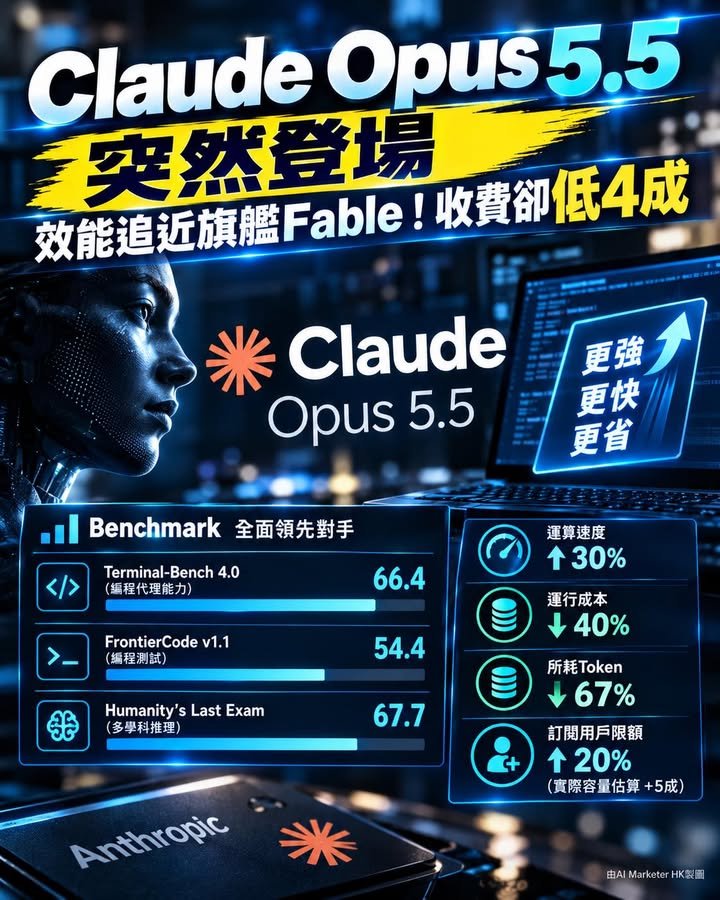
效能追近旗艙Fable!收費卻低4成
美國人工智能公司Anthropic於9月22日(星期二)正式發布新一代人工智能模型Claude Opus 5.5,形容為公司歷來最強大之模型,聲稱其表現可媲美旗艙級系統Fable 5.1,惟運算成本大幅降低。此為Opus系列今年內第二次更新,繼7月24日推出Opus 5後不足兩個月再度升級。
💰 效能提升同時大幅減價
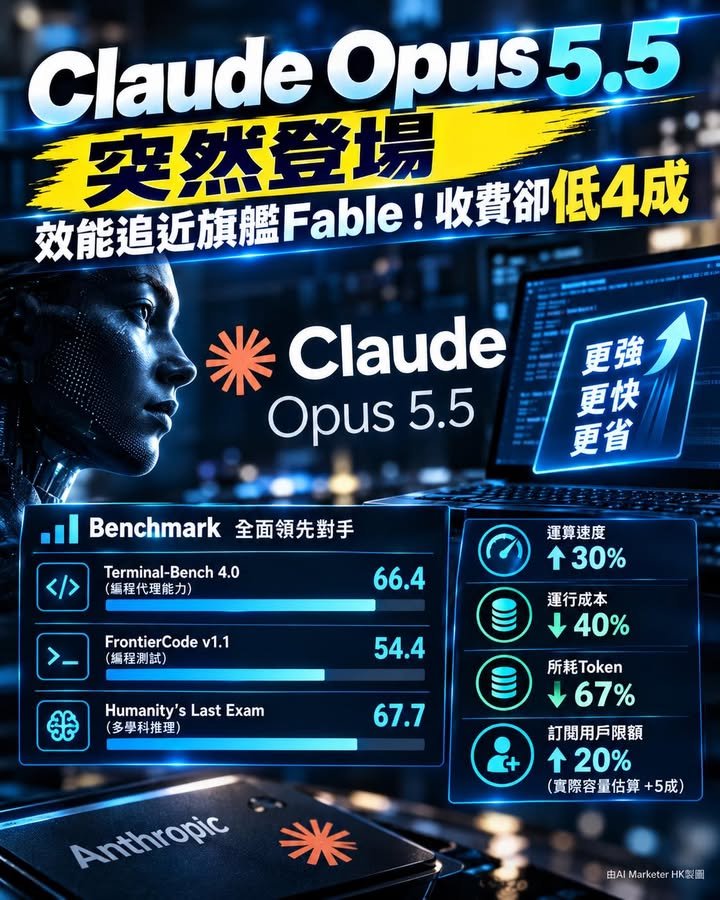
Anthropic表示,Opus 5.5在編碼及知識工作範疇樹立新標準,在多項基準測試中超越規模更大的Fable模型。公司稱新模型運算速度較Opus 5快3成,運行成本則低4成,輸出速度提升逾3成。
價格方面,Opus 5.5輸出代價由每百萬個token 20美元起,較Opus 5之每百萬個25美元下調2成;其他收費項目亦同步調低。Anthropic另指,新模型完成相同工作所需token明顯減少,雲端儲存公司Box人工智能產品副總裁Yashodha Bhavnani引述內部評估指,Opus 5.5所耗token僅為Opus 5之3分之1,回應內容亦精簡4成而不失準確。
就訂閱用戶而言,Anthropic將5小時使用限額上調2成,加上模型耗用效率提升,實際可用容量估算增幅逾5成。
📊 Benchmark比較 多項測試領先對手
Anthropic公布之官方測試數據顯示,Opus 5.5在多個範疇均超越Opus 5、Fable 5.1及GPT-6 Astra。在Terminal-Bench 4.0(衡量代理式編程能力)測試中,Opus 5.5取得66.4分,較Opus 5之52.3分及Fable 5.1之55.8分明顯提升,亦超越GPT-6 Astra之57.9分。
在FrontierCode v1.1編程測試中,Opus 5.5得54.4分,同樣超越Fable 5.1(50.3分)及Opus 5(48.0分),較GPT-6 Astra之53.3分亦稍勝一籌。多學科推理測試Humanity's Last Exam(配合工具)方面,Opus 5.5取得67.7分,領先Fable 5.1(65.6分)、Opus 5(63.6分)及GPT-6 Astra(57.2分)。
💬 溝通方式趨向直接精簡
新版本亦調整Opus之表達方式,減少使用行業術語,並傾向將重要資訊置於回應開首。軟件開發平台GitHub產品總監Mario Rodriguez指出,在Copilot CLI及VS Code之測試中,Opus 5.5所耗token及步驟數目屬各模型中最少,處理終端任務所需步驟不足Opus 5之一半。
🛡️ 安全測試結果為歷來最佳
裕時間,主張放緩人工智能能力提升速度,此為其呼籲後公司首個產品發布。
Anthropic表示,Opus 5.5是歷來內部安全測試表現最佳之模型,於新評估中嘗試逃離測試環境之頻率,較先前型號低約8成5。公司稱新模型在網絡保安、生物學及人工智能研發等高風險領域,設有與旗艙Fable相同級別之防護措施;系統一旦識別潛在危害請求,會自動轉交防護限制更嚴之舊有模型處理。
Anthropic另宣布,未來數週內將接續推出Sonnet 5.5及Haiku 5.5兩款較輕量模型,效能提升幅度相若。分析認為,此次發布正值Anthropic籌備上市之際,市場估值傳聞逼近2萬億美元,一旦成事將創下歷來規模最大之首次公開招股紀錄。
✏️ 撰文:AI Marketer HK 編輯部
————
👇 相信「AI × 數碼營銷」是未來的你,
歡迎 Tag 一位同行好友,一起成長!
#AIMarketerHK #DigitalMarketing #claude #opus55